如果只用一句话回答:别先问哪个模型最先进,先拿你自己的历史销售数据做回测,选那个在你的业务结构里误差最低、并且在市场变化时“错得起”的方法。
具体怎么做?先把历史数据切成真实可用的时间顺序,固定每月重估规则,再用同一个误差尺子比较多个方法。下面我拿蔚来 44 个月公开交付数据,完整做一次。
2019 年,蔚来一度走到退市边缘,李斌被叫作“当年最惨的人”。但六年后的 2025 年,公司交付了 32.6 万台,已经是当年的十五倍还多。
这条被骂着往上翻倍的曲线,正好可以用来检验十种预测方法。
我拿蔚来 44 个月的公开交付数据,把十种预测方法挨个回测一遍:哪种在什么场景下准,误差怎么算,什么时候全都会失灵。
规矩:每月重估,谁也不许偷看
预测的真本事,不在解释昨天,在站在今天猜明天。
事后看,人人都是诸葛亮。
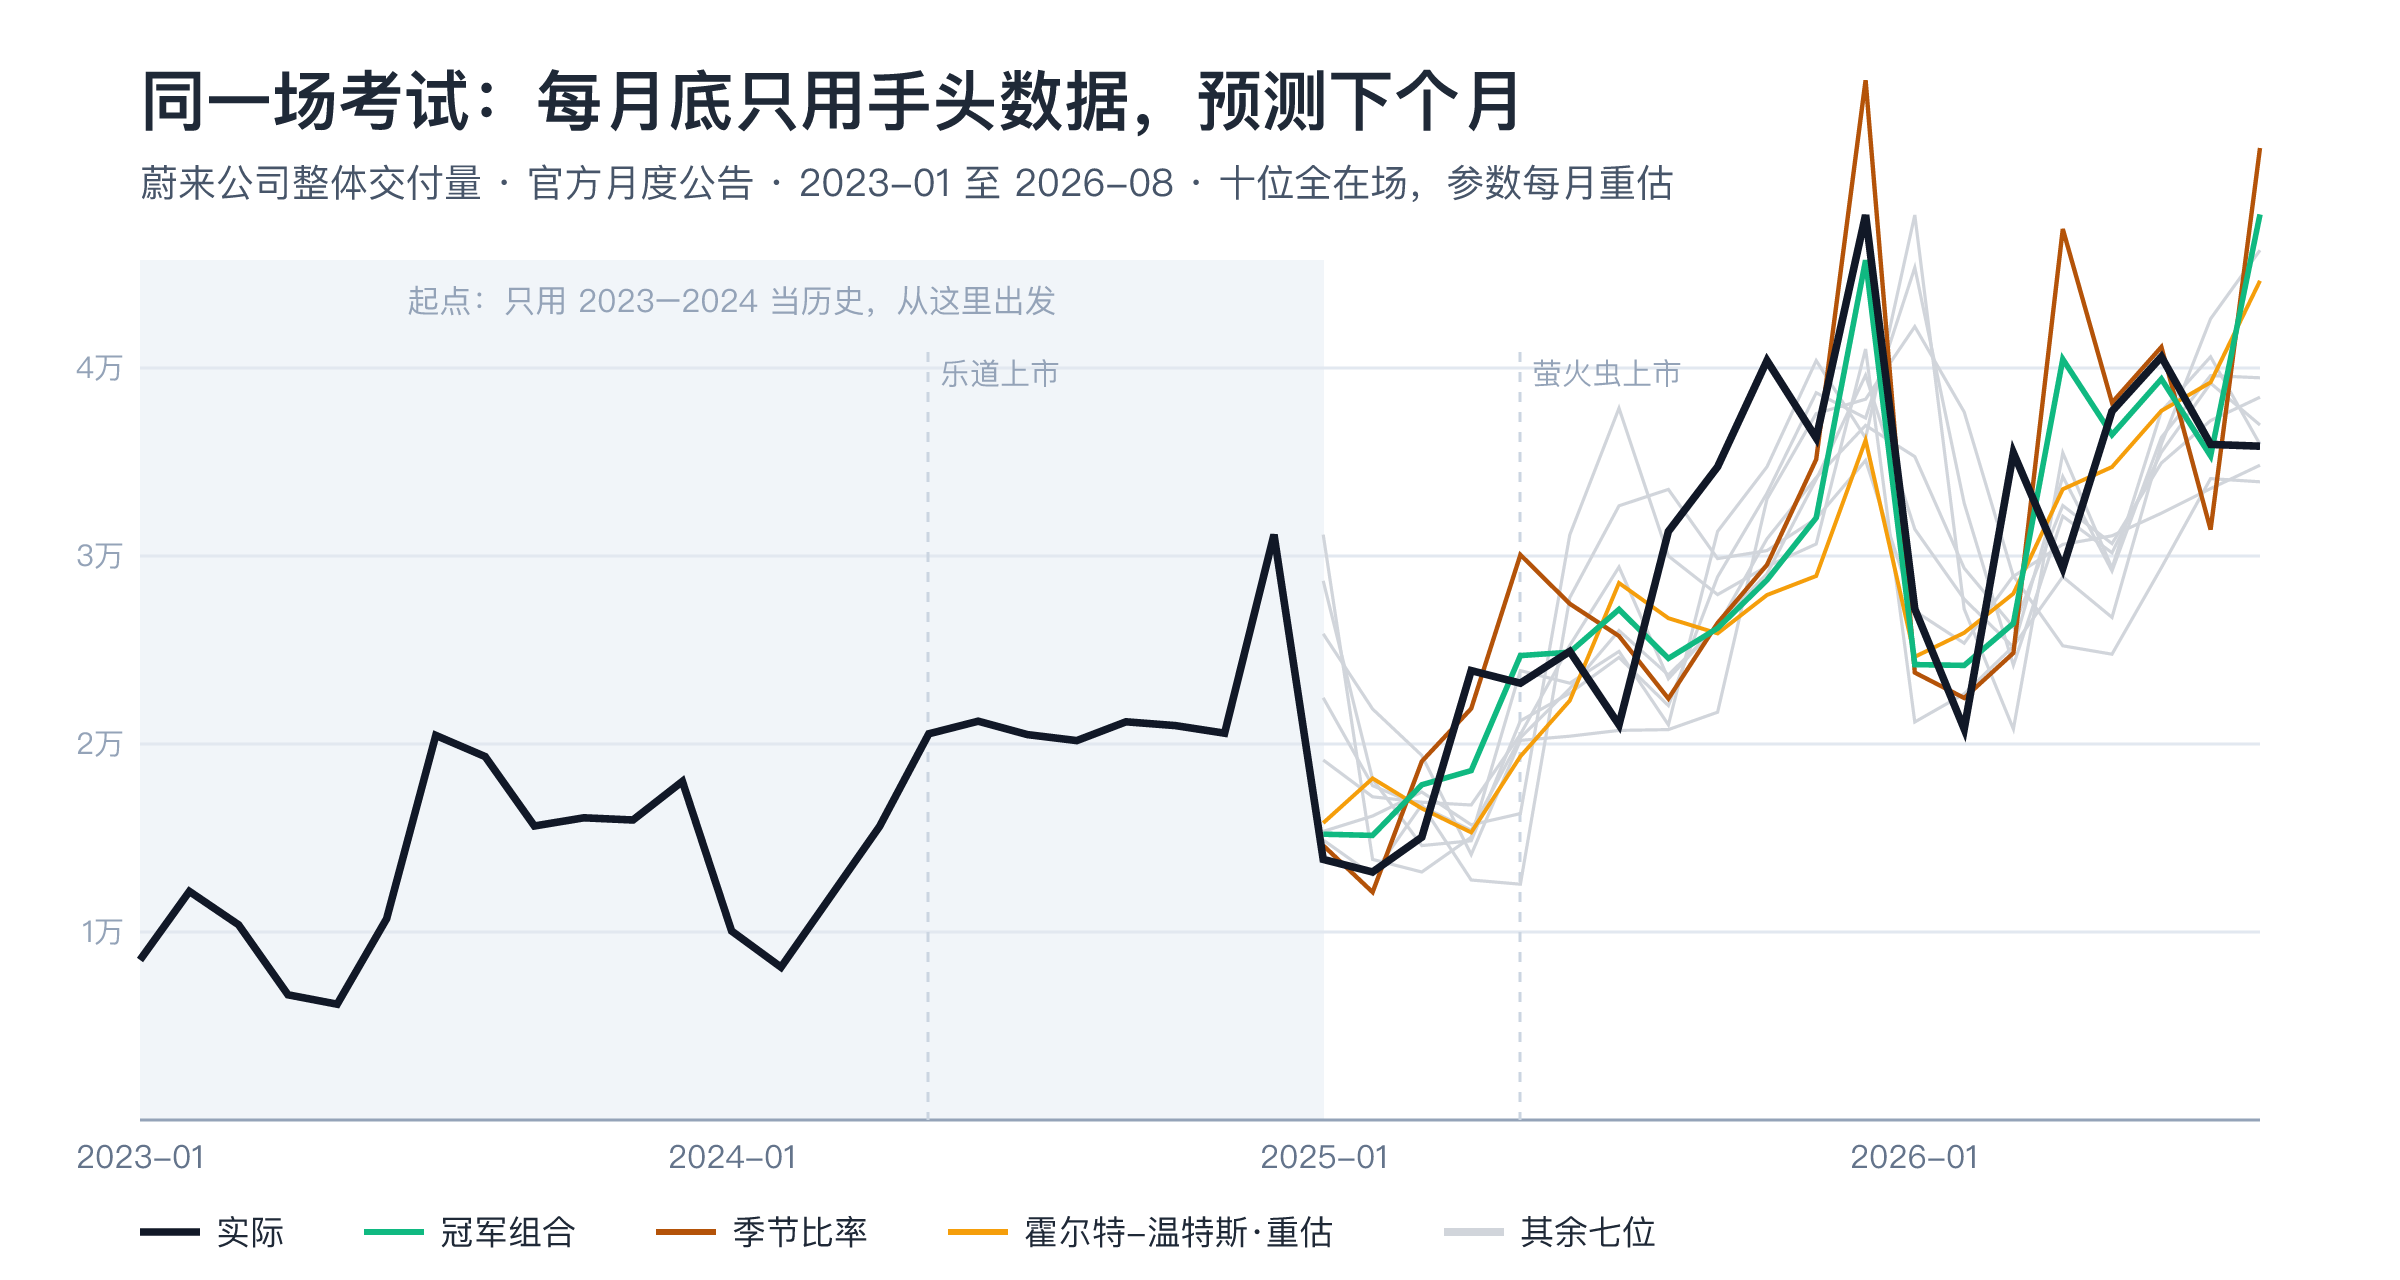
所以规矩定死。2023 到 2024 两年,当历史教科书。
从 2025 年 1 月起,每个月的最后一天,十位选手各自只用手头的数,报出下个月的数。
还有一条,跟现实对齐:每月实际数一出来,允许回头重调参数——真实世界里,计划员每个月都会拿新数据把模型重新校一遍。有参数的重估参数,没参数的按定义出招。
下个月一到,对答案,记分。连考 20 个月。
谁也不许偷看未来——包括我。
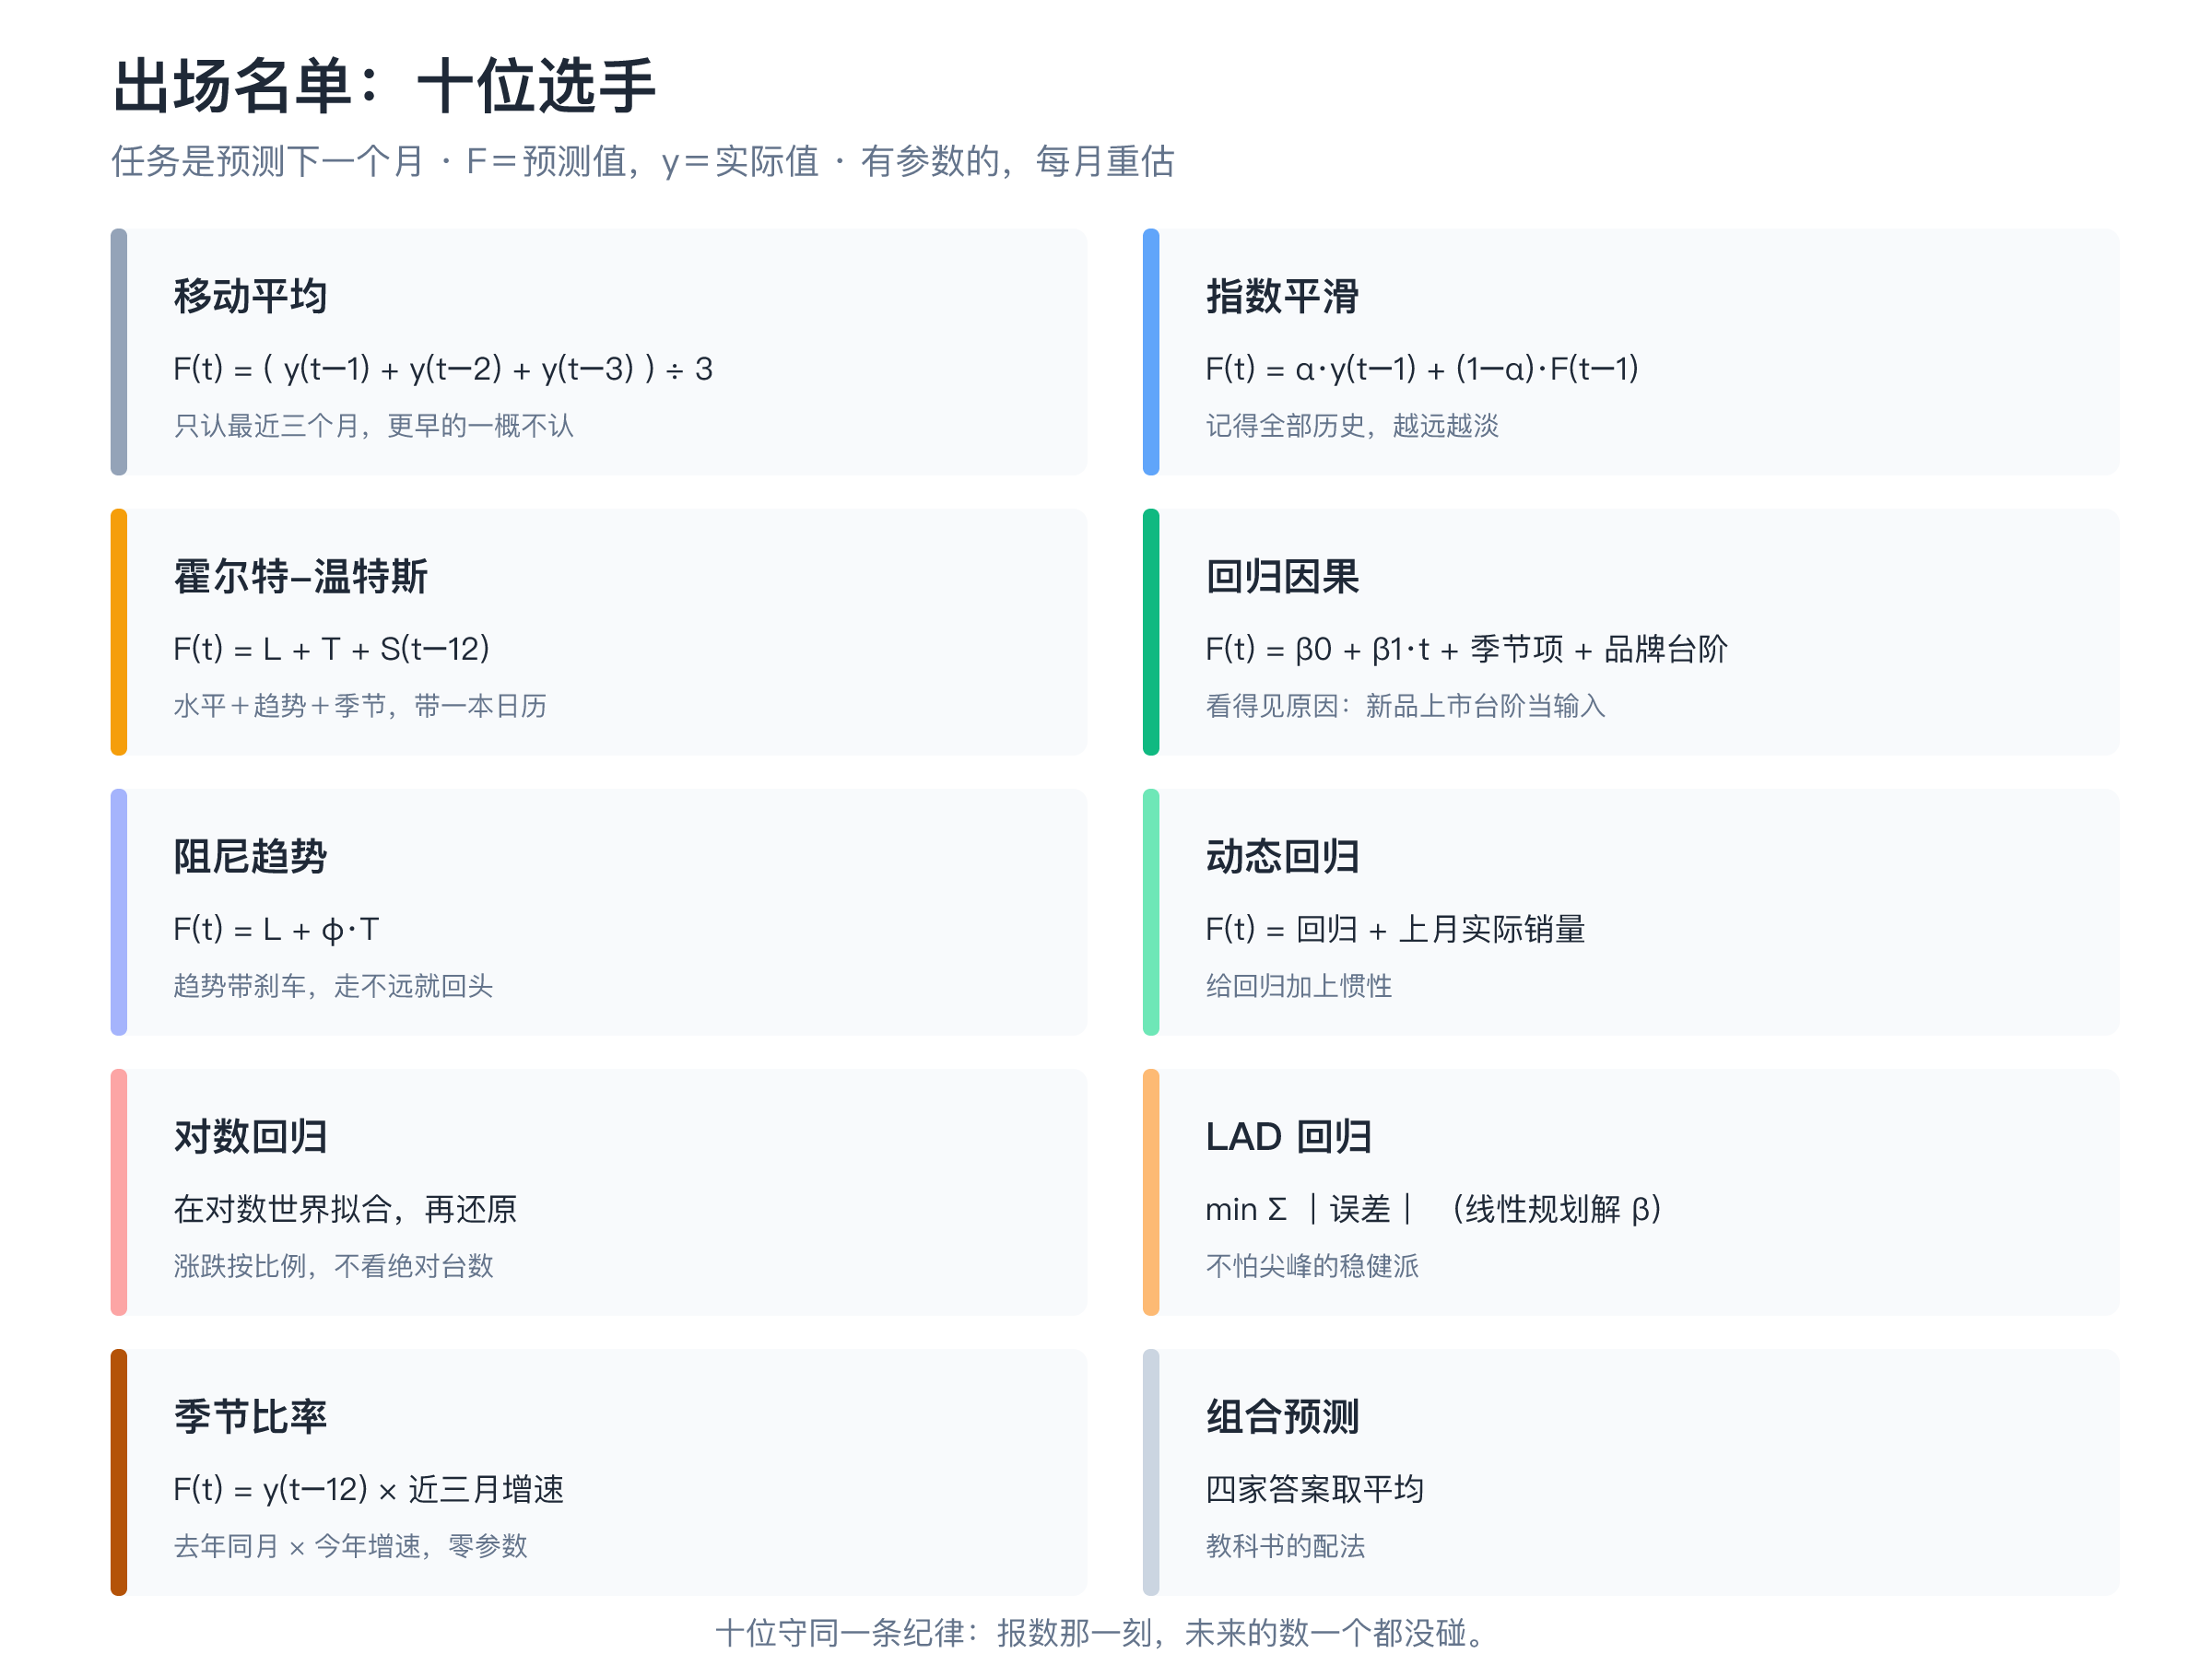
出场名单:十位选手
公式在图上,脾气在公式里。
总成绩
20 场全算,一场不落。尺子是平均百分比误差:MAPE=(1/20)·Σ|F(t)−y(t)|÷y(t),每个月偏离实际百分之几,20 个月平均。
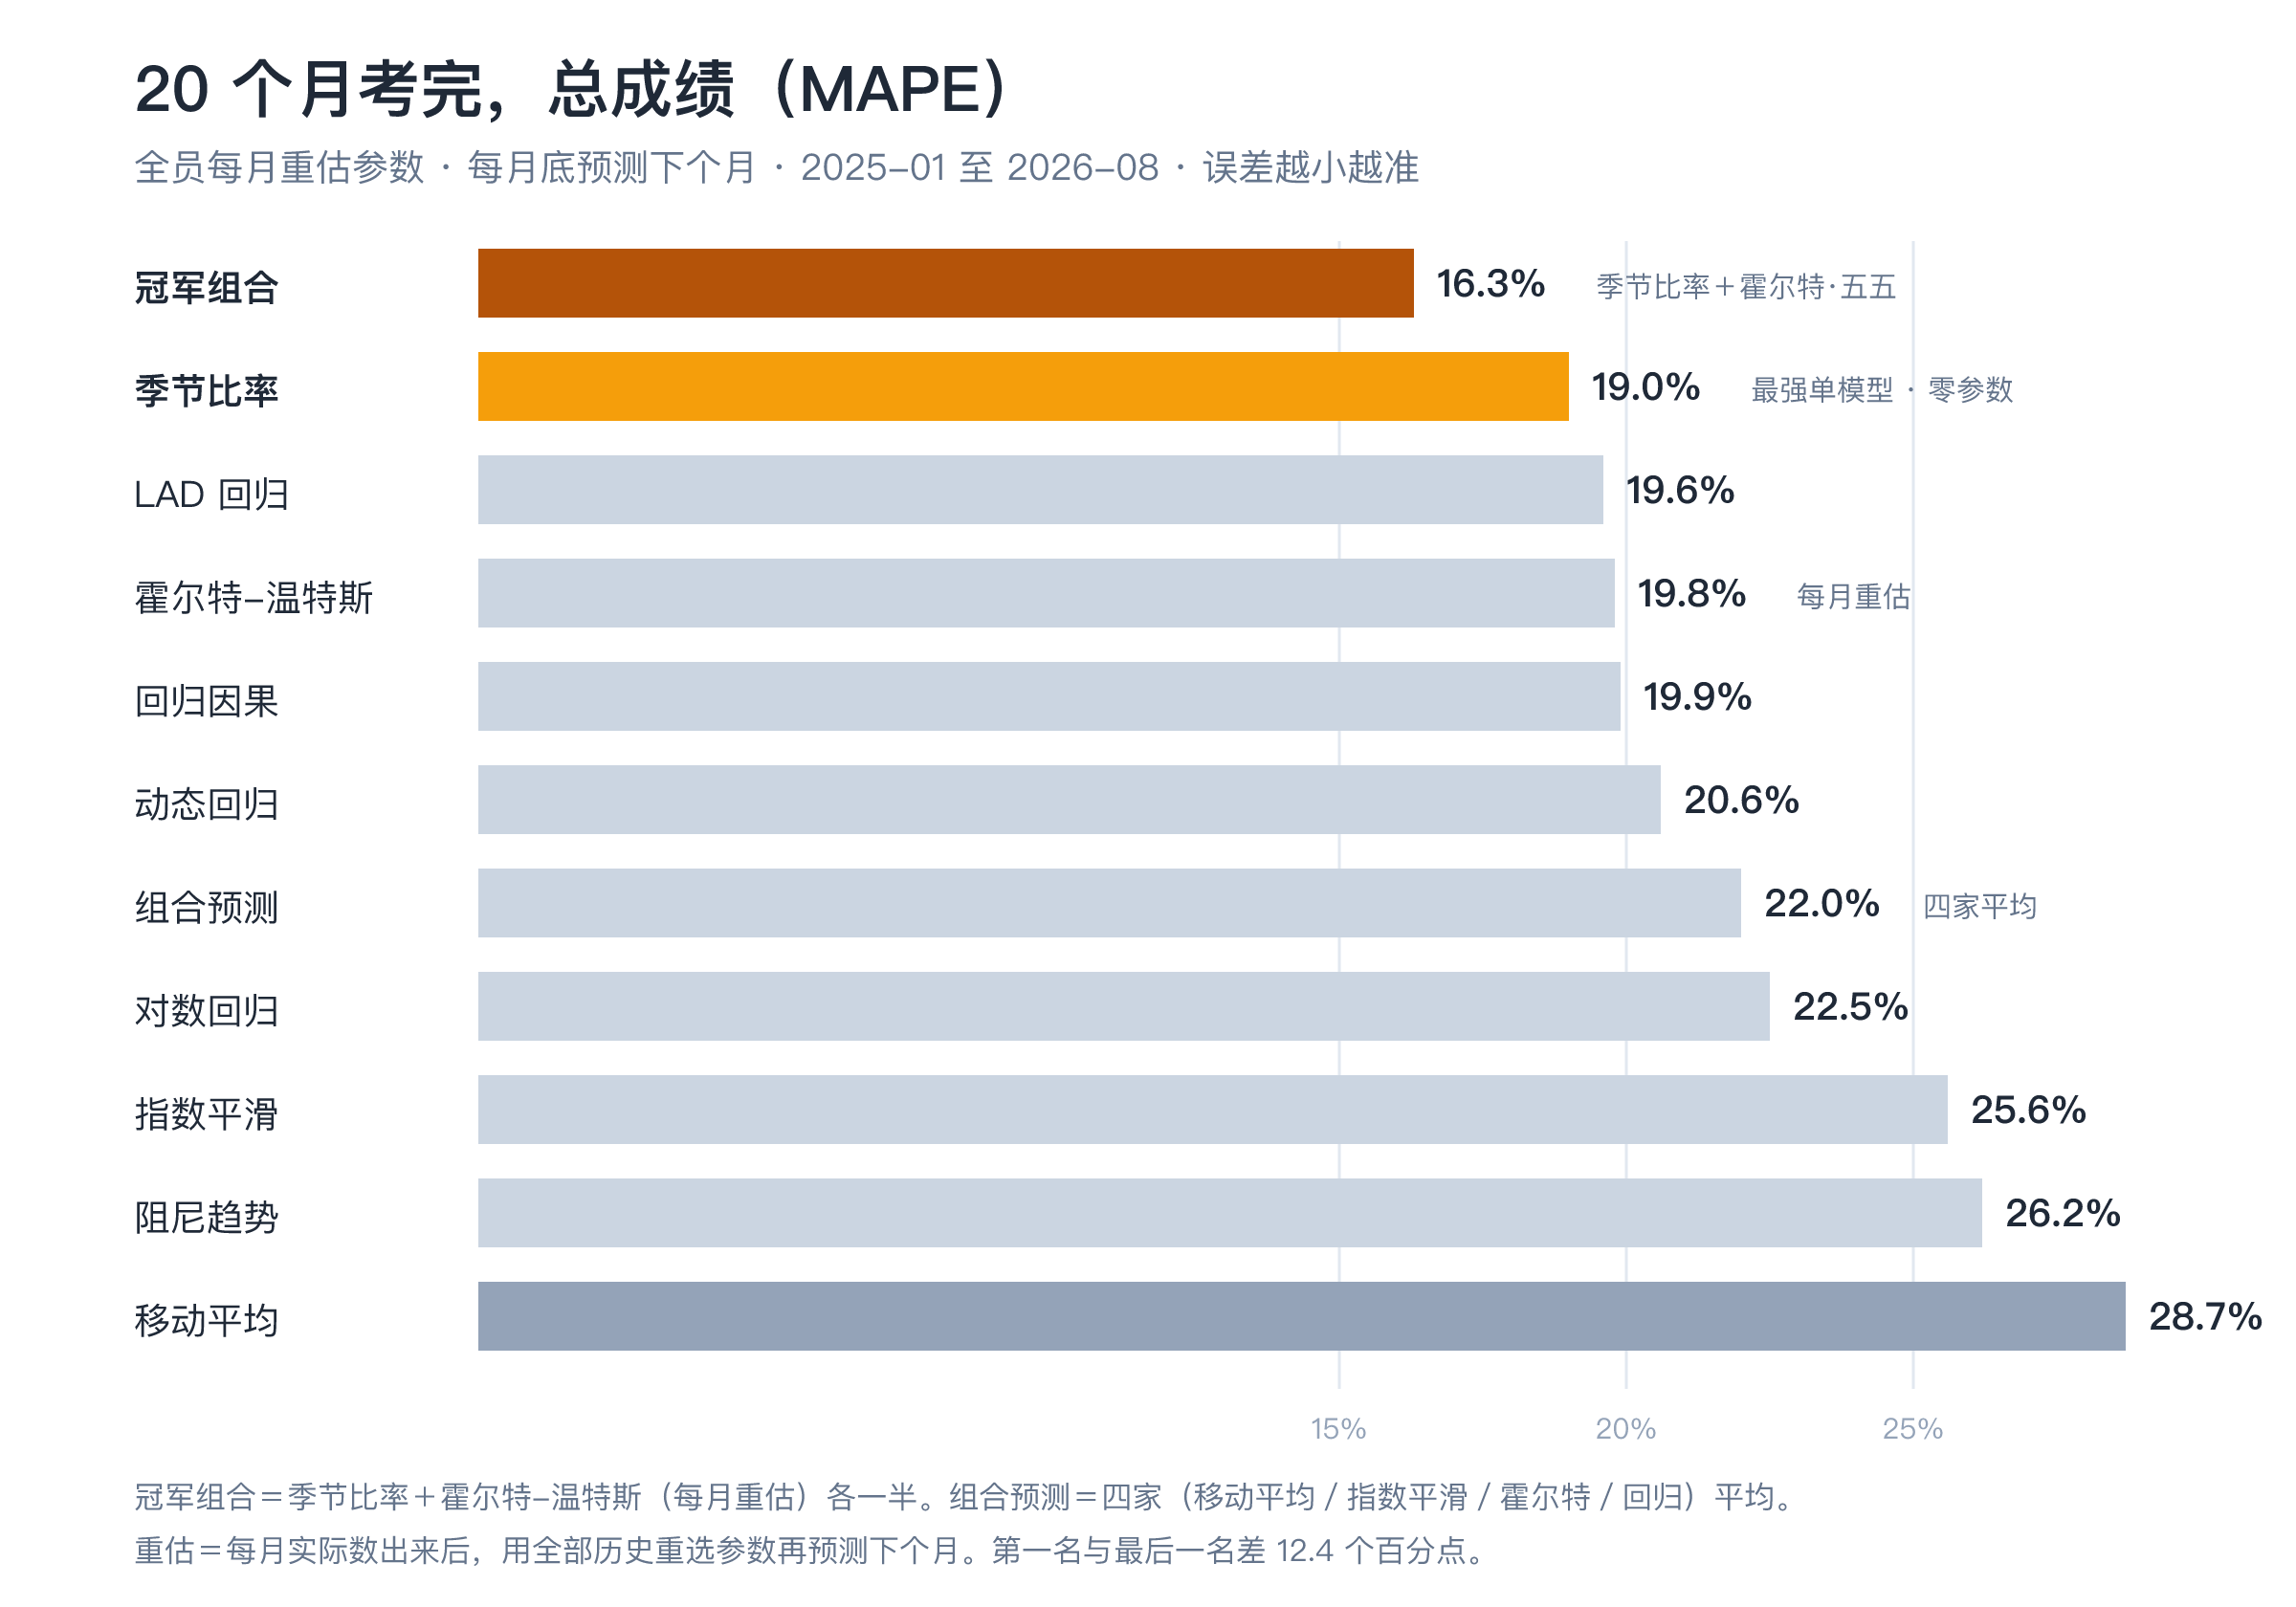
榜首不是单干户:季节比率加霍尔特-温特斯,五五平均,16.3%。
最强单模型是季节比率,19.0%,零参数。
它强在季节:别的选手的季节,是从历史里拟合出来的形状;它的季节,是去年十二个月真实跑出来的形状。2 月的坑有多深,它不用猜,去年挖过。
但也别把它供起来。2023 年 2 月,环比涨了四成三——那年 1 月是补贴退坡加春节的双重谷底。季节是统计出来的倾向,不是物理定律。
LAD 回归 19.6%,霍尔特-温特斯 19.8%,回归因果 19.9%——第二到第四挤在半个点里。
最笨的移动平均 28.7%,跟冠军差 12.4 个点。按月均三万台算,每个月差出三千六百台的判断。选错方法不是风格问题,是钱的问题。
赢家和输家的道理
先说组合为什么赢。季节比率的长处是真实的季节,短处是把增速当成三个月不变;霍尔特-温特斯每月重估,跟得住变化,短处是季节靠拟合。两家的短处不重叠,五五平均,各自的错抵掉一截。
但组合不是平均就有用。四家全平均的组合预测,22.0%,中间偏下——最强的和最差的一勺烩,强者的优势也被稀释了。
组合的诀窍就一条:找互补的,别凑一堆。
再说重估。霍尔特-温特斯不重估是 22.9%,重估后 19.8%——它的参数描述的是现在的水平、现在的趋势、现在的季节,市场变了,参数就该跟着走。
可重估不是万能药。给季节比率也装上自动选窗口,它就开始追涨杀跌:最近谁准就抄谁,19.0% 掉到 23.3%。
它的“近三月增速”是方法定义,不是旋钮。有些东西,就该拧死。
错得起
回到 2019 年。给蔚来判死刑的人,模型其实不差:亏损、股价、交付量,样样有据。
他们输在假设——明年像今年。
可生意的世界里,“不像”才是常态。上新品、换政策、出对手,这条曲线六年翻十五倍,靠的全是模型看不见的东西。2025 年 11 月,李斌自己都说,补贴退坡的影响“是行业未预料到的”——公司都料不到的拐点,模型更不可能。
所以别把那 16.3% 当模型的失败。它不是极限,是这条曲线的变数本身——你可以逼近它,消灭不了它。
真正的分水岭,不在猜得准不准,在错了怎么办。
要区间,别要单点:“下个月 3 万台”是承诺,“2.6 到 3.5 万”才是工具。留安全库存接住波动,留柔性产能当后手。把“会错”设计进流程的人,误差是成本;不设计的人,误差是事故。
猜得准是运气,错得起是本事。
做了二十多年供应链,我见过的赢家,没一个是猜得最准的,全是错得最便宜的。
回到问题:基于历史销售数据做预测,步骤是什么?
不是把历史数据一股脑丢进模型,而是:先把回测规则定成真实工作;每月重估,不许偷看未来;用同一个 MAPE 比较单模型;组合只选互补的;最后承认结构性突变预测不了,用区间、库存和柔性产能兜底。
历史数据能告诉你“过去什么有效”,不能替你保证“未来一定重复”。所以它要做的事,是让你少犯错、错得起,而不是假装不会错。